
一份病案里,可能同时有扫描 PDF、检验报告图片、知情同意书和手写签名。用于教学、科研资料准备或对外交流时,需要按使用范围处理其中的个人信息,再检查页序、合并文件。
本工具可以将目录批处理、OCR、信息遮盖、人工调整和导出预览放到一个 Windows 客户端中,让这项工作有清楚的操作入口和处理状态。
一份病案一个目录,多份资料批量执行
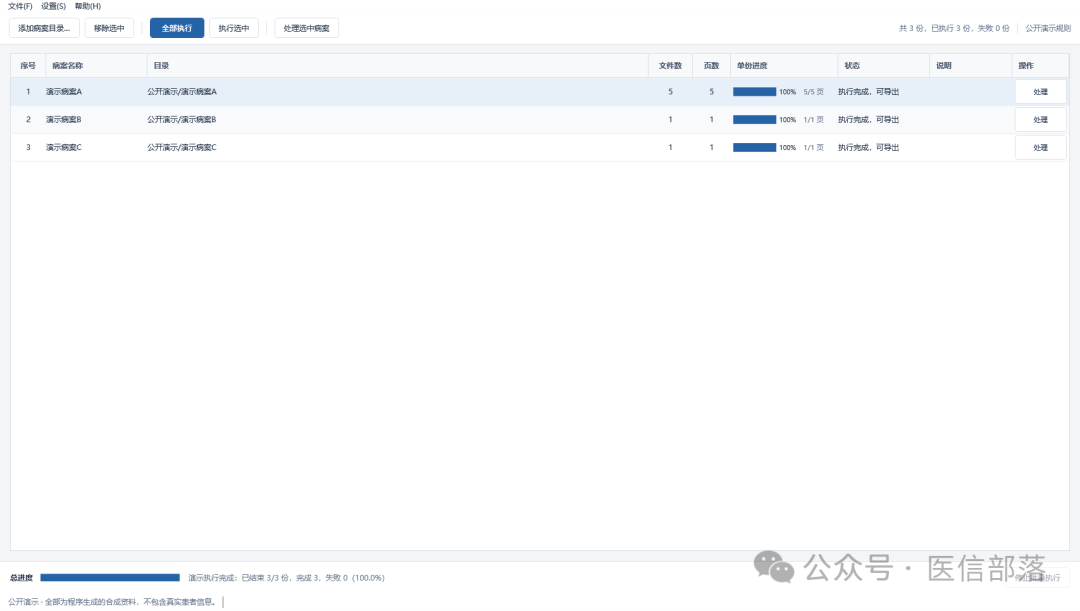
准备好病案目录后,点击“添加病案目录”,可以一次选择一份或多份。每份病案在列表中独立显示文件数、页数、进度和状态。
点击“全部执行”,软件依次读取 PDF 或图片,在本机进行中文 OCR、病案类型识别和敏感信息匹配。底部显示整体进度,每一行显示本份进度。某份完成后,即可打开处理窗口,后台继续处理其他资料。
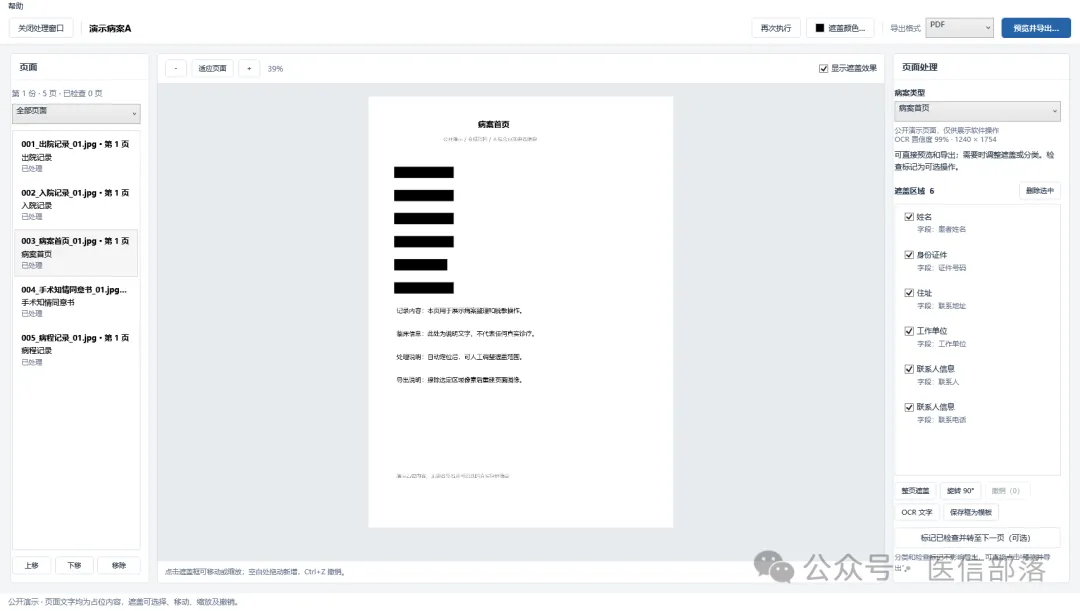
自动定位后,遮盖范围可以直接调整
工具支持按规则识别患者姓名、身份证件号码、住址、工作单位、联系人和联系方式,以及患者、家属或代理人的签名区域。医院名称支持配置全称、简称或别名;签名范围也可按业务要求设置。
点击列表中的“处理”,会打开独立窗口。选中遮盖区域后,可以移动或缩放;需要补充的位置可直接框选。误操作可以撤销,遮盖颜色可以自选。
软件保留人工处理的入口。分类与检查标记不作为导出的强制门槛,操作人员可以根据资料质量和实际用途安排检查。
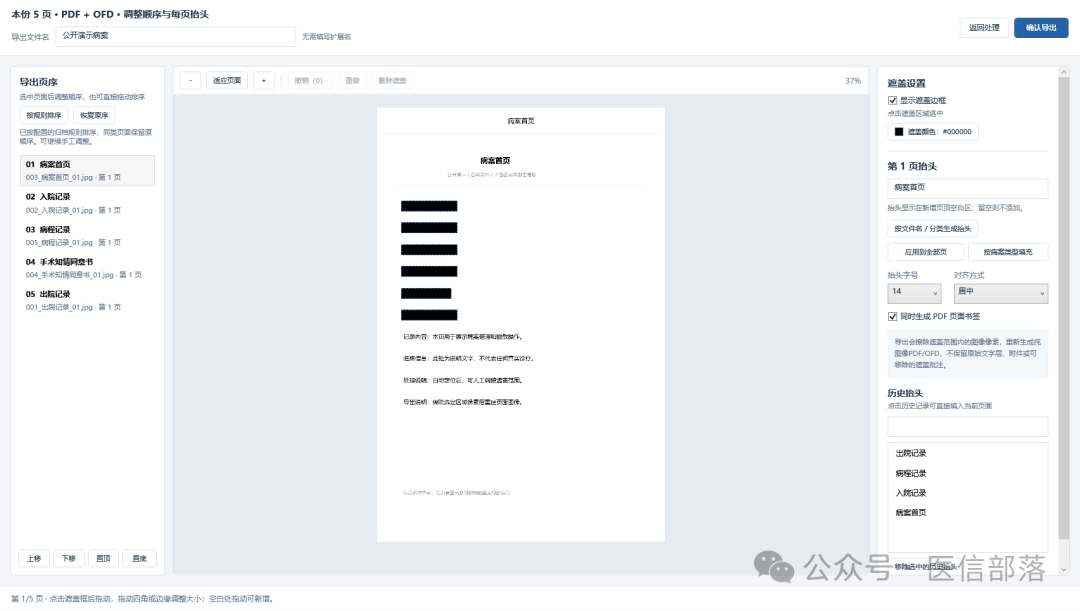
抬头自动建议,归档顺序可以配置
文件名中已有中文文书名称时,导出抬头优先保留其中的中文,去掉数字、字母和符号。例如,001_入院记录_02.pdf 会建议为“入院记录”。没有中文时,采用有效的病案分类结果;还可以手工修改或留空。
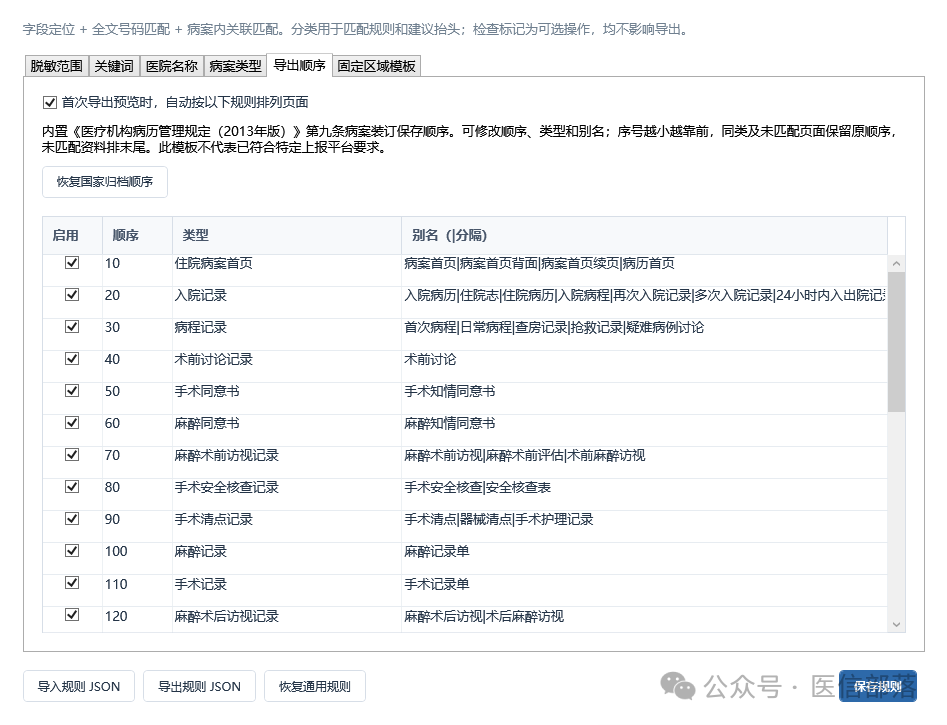
导出预览内置病案归档顺序。它依据《医疗机构病历管理规定(2013年版)》第九条的病案装订保存顺序,并允许医院调整顺序和类型别名。同类页面保留原有先后顺序,未匹配的资料放在末尾,不会因没有分类而被删除。顺序依据可查阅国家卫生健康委原文。
预览中仍可拖动页面、上移或下移,设置每页抬头、字号、对齐及 PDF 书签。常用抬头支持在本机记住,下次可以直接选用。
导出时擦除像素,处理双层 PDF 的隐藏文字
扫描 PDF 可能同时包含页面图像和用于检索的隐藏文字层。只在原文件上放一块可移除的矩形,不能达到这里的处理目的。
本工具先将页面渲染成图像,再用不透明颜色替换启用遮盖区域内的像素,最后重新生成 PDF 或 OFD。成果不带入源 PDF 的隐藏文字层、原始附件、表单或原有批注;遮盖是输出图像的一部分。导出前还会检查成果结构,校验通过后才生成最终文件。
这也意味着,导出的正文是图像,不保留原始可搜索文字层。自动定位的完整性仍取决于扫描质量和 OCR 结果,模糊文字、特殊表格及无标签的手写内容需要人工检查和补充。
本机处理,按医院实际资料使用
工具适用于 Windows 10/11 x64,随附中文 OCR 模型和运行时,可离线处理 PDF、JPG/JPEG、PNG、BMP 和 TIFF。导出支持 PDF、OFD 或两种格式同时生成;文件名可修改,同名文件自动追加序号。
评论区